 RockCloud-基石云安全-官方博客
发现账单异常或者GPU队列被塞满时,按这个顺序动手:吊销并轮换密钥 → 在提供商侧设消费硬上限 → 在边缘接入层按接口路径限频并阻断异常特征 → 隐藏推理源站 → 再回头补网关层的多维度限流。
注意一点:大模型接口不能照搬传统REST API那套「单IP每秒多少次」。成本压在Token和GPU推理时长上,一个超长prompt加上超大 max_tokens,请求数只有1,花掉的钱可能顶得上几千次普通调用。所以限流阈值要换维度。
先花两分钟确认是哪一种盗刷
三种情况的处置动作不一样,判错了会做无用功。看提供商控制台或网关日志的三列数据:调用来源IP分布、模型分布、单次Token消耗。
- 主Key泄露:Key被提交进Git、打包进前端、打进日志或截图外流。特征是调用来自完全陌生的IP和UA,模型选择和参数很杂乱,经常有人拿你的Key去跑与你业务无关的任务。
- 前端接口被抓包复用:你自己的业务接口没有强鉴权,或者只做了Referer校验。特征是调用路径就是你自己的接口,但Referer、UA对不上,或者同一个用户ID的调用量远超正常使用。
- 分布式刷量:通过住宅代理池或肉鸡轮换IP。特征是单IP频次都不高,但IP极度分散、总Token量暴涨,常伴随超长输入或流式长连接挂着不断。
第三种最容易判错。如果你发现每个IP的请求数都在阈值以内、总消耗却在飙升,就别再去调单IP频次阈值了,那条路堵不住,得换成指纹和行为维度。
第一小时的止血顺序
1. 轮换密钥。 属于Key泄露就到提供商控制台吊销当前Key、生成新的,新Key只放服务端环境变量或密钥管理服务里。吊销前先确认线上哪些服务在用这把Key,避免把自己的业务一起停了;如果来不及分辨,先按最小损失原则停掉,再逐个恢复——账单是按秒涨的,停服比超支好收拾。
2. 设消费和配额硬上限。 多数商用大模型提供商支持账号级或项目级的用量上限与告警;自建推理集群则在网关上配日配额。这一步是兜底:后面所有限流规则都失效时,它决定你这一天最多亏多少。很多团队是被盗刷之后才想起来这个开关一直没打开。
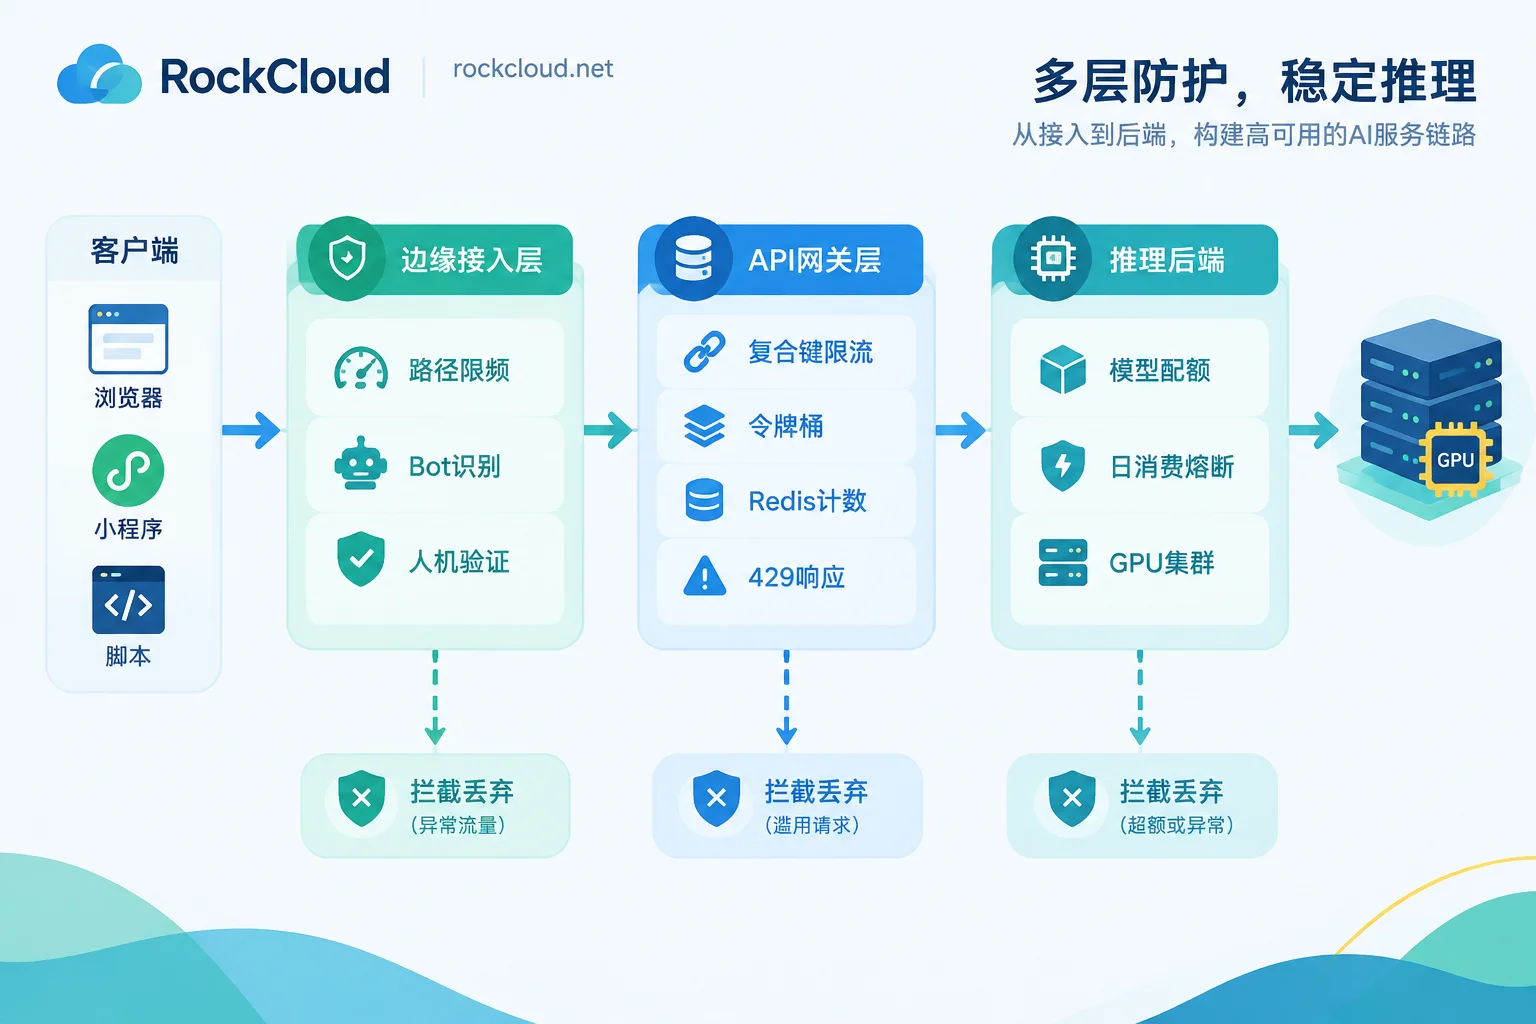
3. 在边缘接入层按接口路径限频、阻断异常特征。 对 /v1/chat/completions 这类推理路径单独设频次和并发上限,不要和静态资源共用一套规则。同时拦掉非法Referer、空或异常的User-Agent、已知代理IP段;对疑似批量来源加JS质询或人机验证。放在边缘做的好处是请求还没到推理后端就被丢掉,算力和Token都不花,而放在应用层拦截时GPU可能已经开始跑了。
如果现在正在被刷、手上还没有可用的边缘拦截能力,可以先把域名接到 WAF 与 CC 防护 上,用路径限频和Bot识别顶住,再慢慢补精细规则;情况紧急可以直接走 应急接入。
4. 把推理源站藏起来。 如果对方已经拿到你的推理服务器IP、绕过边缘直连,前三步都白做。回源改成只放行边缘节点IP,或者加回源鉴权头。具体做法可以参考源站隐藏怎么做?暴露面到mTLS回源的5道关口。
大模型限流要限的四个量
止住血之后,把限流规则重建一遍。针对大模型接口,至少要覆盖这四项,缺一项就留一个口子:
| 限什么 | 为什么需要 |
|---|---|
| 请求频次(RPM/RPS) | 基础防护,挡住最粗暴的循环调用 |
| 并发连接数 | 流式响应(SSE)会长时间占住连接和显存,光限频次挡不住挂长连接 |
单次上下文长度与 max_tokens | 防止用超长输入或超大输出参数单发高成本请求 |
| Token消耗速率(TPM/TPS) | 真正贴近成本的维度,前三项都在阈值内也可能被它击穿 |
第三项特别容易漏。服务端应该对 max_tokens 做上限截断,而不是原样透传用户传来的值;上下文长度同理,超过业务合理范围的直接拒绝。
网关层限流怎么配
用复合键,不要只用IP。 限流粒度建议是 用户ID + API Key + 目标模型 的组合,IP只作为辅助维度。原因是分布式盗刷下IP已经不可靠,而同一个用户对不同模型的合理用量本来就该不同。
算法用令牌桶或滑动窗口。 令牌桶允许一定突发,适合正常用户偶尔连发几条;滑动窗口统计更平滑,适合按分钟计的Token配额。多实例部署时必须用Redis做分布式原子计数,否则每个实例各算各的,实际放行量是阈值乘以实例数。
超限返回 429 加 Retry-After。 不要用超时、断连或500来表示限流——客户端分不清是被限了还是服务挂了,通常会立刻重试,反而加重压力。正确的429配上重试间隔,正常客户端会退避。
按模型做差异化配额。 旗舰模型单位成本高,配额给紧;轻量模型放宽。同时给免费/试用账号和付费账号分池,别让试用流量把付费用户的容量挤掉。
加账号级日消费熔断。 单日消费触到阈值就停止该账号调用并告警,这是限流之外的最后一道闸。触发条件建议按金额而不是请求数设,因为金额才是你真正在意的量。
架构上根除问题
止血和限流都是应对,下面这几条是让同类事故不再发生的前提:
- 前端、小程序、桌面客户端里绝不放长期主Key。 打包产物可以被反编译、抓包,所谓的加密存储只是提高一点成本。所有调用走业务服务端中转鉴权。
- 需要端侧直连时下发短期临时凭证。 由服务端签发带时效的临时Token,配合Nonce防重放,泄露后的有效窗口只有几分钟。
- 监控盯Token速率和人均消费曲线,不是只盯请求数。 设置突变告警并推送到能立刻看到的渠道(比如Telegram),盗刷通常在几十分钟内就能造成明显损失,靠第二天看账单太晚。
- 限流规则上线后跑一遍正常业务。 新规则误伤自己的回调或批处理任务是常见事故,排查思路可以参考WAF把支付回调拦了怎么加白名单,按路径和来源精准放行,别整条规则关掉。
两个会改变具体做法的前提
你是自建推理还是代理外部商用API。 自建vLLM/Ollama集群时,损失是GPU算力和可用性,熔断阈值应该按并发和显存占用设,重点保住正常用户的服务质量;代理商用API时,损失直接是账单,重点是提供商侧的消费上限和Key管理,这两者的止血优先级刚好相反。
你现有的网关形态。 APISIX、Kong、Higress这类网关自带限流插件,配置复合键和Redis计数即可;如果目前只有Nginx,limit_req 只能做到IP或固定键维度的频次控制,Token维度的限流需要在应用层自己实现,或者在前面补一层AI网关。先确认手上有什么,再决定哪一层承担哪个维度,避免同一个限制在三个地方各配一遍、互相冲突。


评论(0)