 RockCloud-基石云安全-官方博客
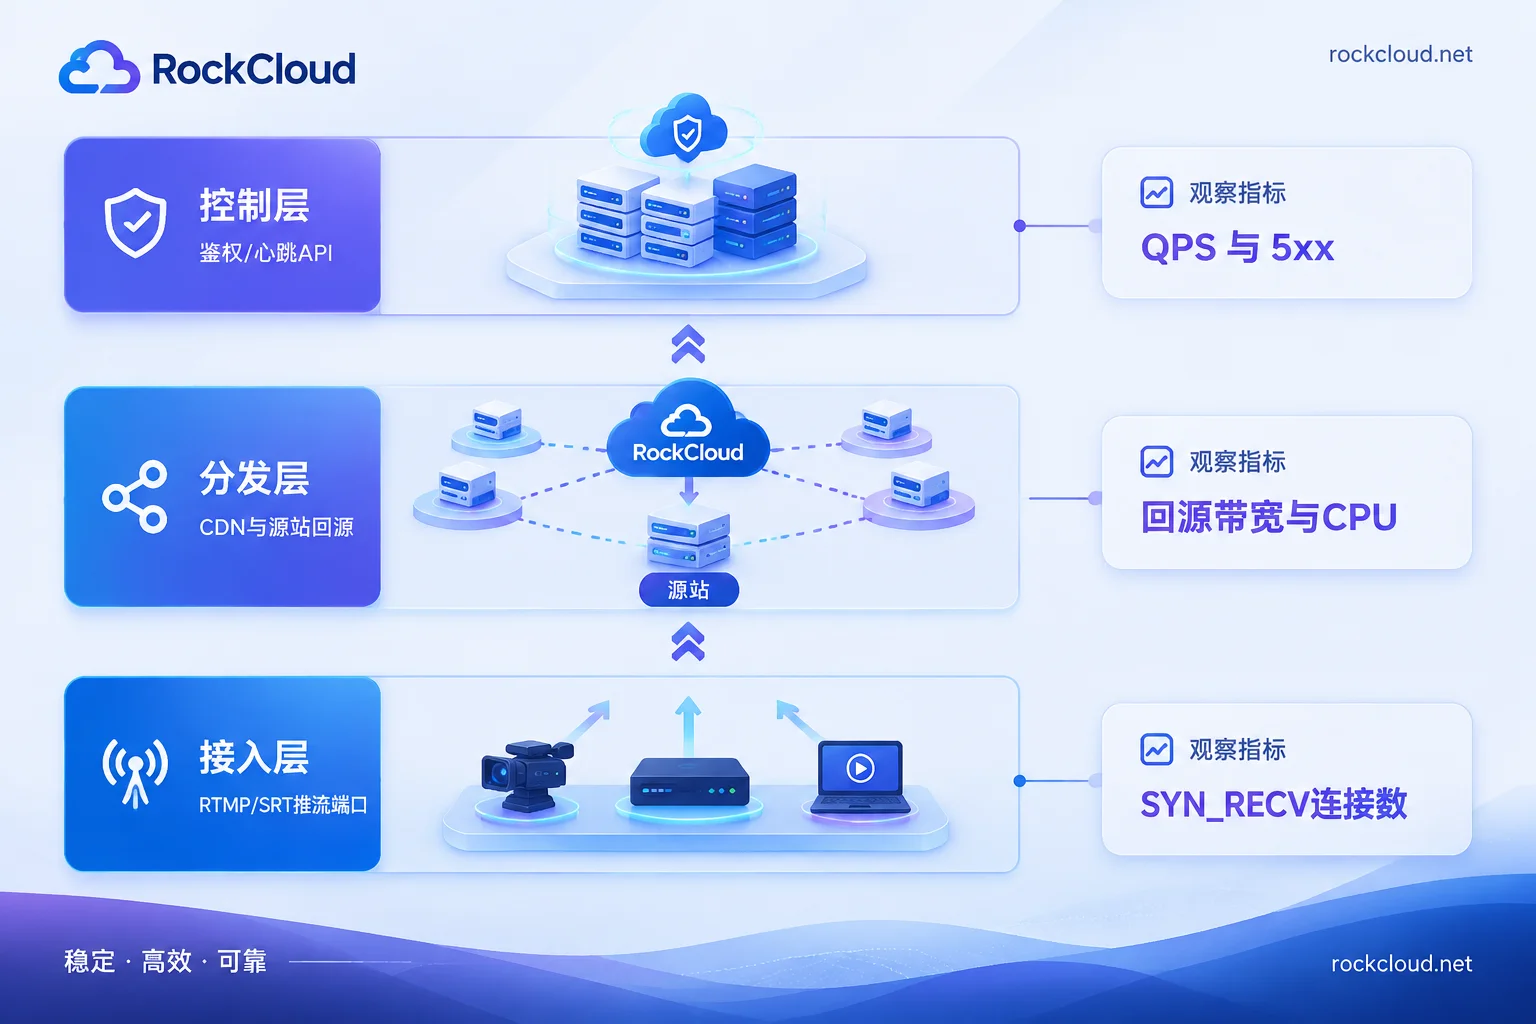
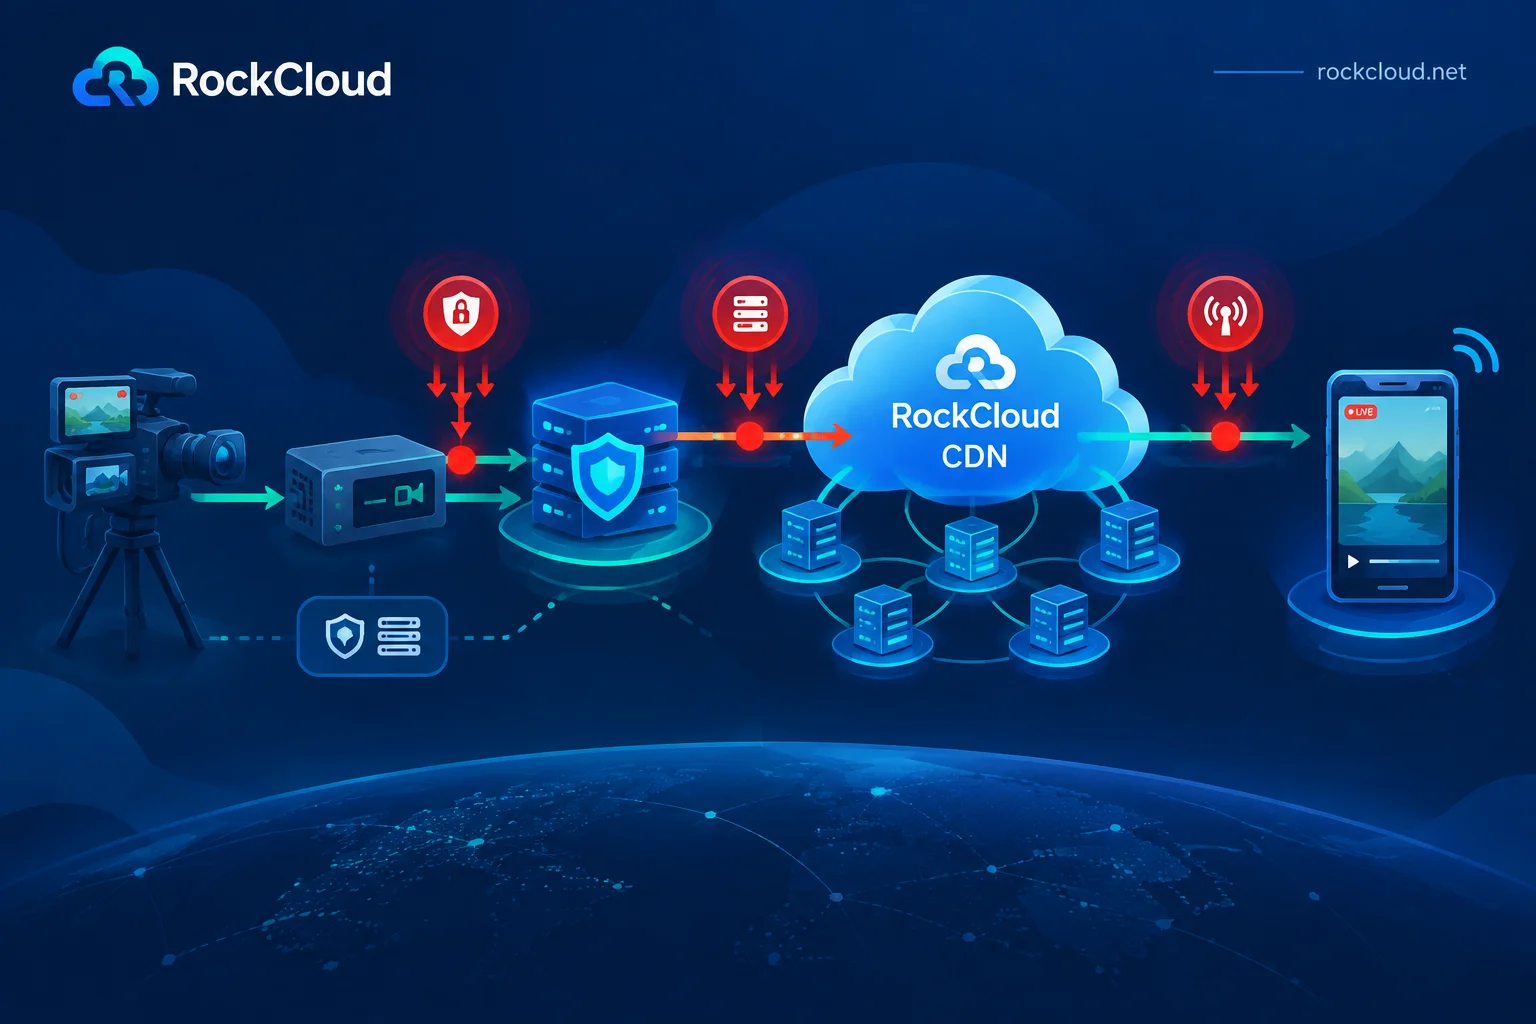
直播间开始卡顿、主播端频繁重连,第一件事不是去买防护,而是分清哪一层在扛不住。直播链路上至少有三个独立的受害点,处置动作完全不同,搞错了会白忙一小时:
- 控制层:房间心跳、推流地址下发、鉴权/上报接口被 HTTP Flood 刷爆,主播端握手失败、反复重连,但媒体流本身没打满;
- 分发层:播放侧的恶意请求穿透 CDN 直接回源,把源站的出入带宽和 CPU 耗光,推流服务与拉流服务同机部署时会被一起拖垮;
- 接入层:推流端口(RTMP 的 1935/TCP、SRT 的 UDP 端口等)暴露在公网,被空连接、畸形连接占满连接数或半开队列,新的推流根本建立不起来。
下面按“定位 → 止血 → 收口 → 加固”的顺序讲,每一步都能在当次事故里做完。
第一步:十分钟内确定受损层
同时看四组数据,哪一组先异常,哪一层就是当前的瓶颈:
- 推流端日志。OBS、SDK 或 ffmpeg 的报错要看清楚:连接被拒/超时,说明卡在接入层或网络;能连上但获取推流地址失败、鉴权返回 4xx/5xx,说明是控制层接口的问题;能推上去但上行码率反复跌到零,更可能是主播侧上行带宽或弱网,不一定是攻击。
- API 侧的 QPS 与错误率。把“获取推流地址”“房间状态上报”“心跳”这几个接口单独拉出来看:QPS 是否短时间翻了几十倍、来源 IP 是否高度集中或异常分散、UA 与签名是否大量缺失。控制层被刷时,这里的 5xx 和响应时间会先于媒体指标恶化。
- 源站的带宽、连接数与 CPU。出向带宽打满、TIME_WAIT/ESTABLISHED 连接数暴涨、回源请求量远高于平时的播放人数,基本可以判定是播放侧穿透回源。
- 推流端口的连接状态。大量处于 SYN_RECV 或建连后不发数据的连接,集中指向 1935 等推流端口,就是接入层被空连接耗尽。
先做这一步的意义在于:如果不区分层级,直接在 WAF 上狂加规则,对四层端口的攻击没有任何作用;反过来只忙着换源站 IP,控制层接口照样被刷。
第二步:按层止血
信令与鉴权接口被刷
在 WAF 上对受影响的接口做精细化限流,而不是全站统一阈值:对获取推流地址、房间状态上报这类接口,按 IP、Session 或 Token 维度分别设频率阈值,超阈值先降速再阻断。
这里有一个很容易踩的坑:Web 端和原生端要分开配策略。浏览器侧可以开 JS 校验或滑块挑战;但 App 和服务端调用的原生 API 接口不能开网页挑战,客户端没有执行 JS 的环境,开了就是大面积误杀自己的用户。原生接口的正确做法是校验签名——没有携带有效签名、或参数畸形的请求直接丢弃。
限流生效后,留意有没有把正常业务一起拦掉:开播高峰期心跳接口的正常 QPS 可能本来就不低,阈值要参照平峰的真实曲线来定。如果接入了 WAF 后出现回调类请求被误拦,处理思路可以参考WAF 误拦后按路径精准放行的做法。
播放侧穿透回源,打垮源站
典型手法是给播放地址挂上随机 Query 参数,让每个请求都成为“未命中”从而直达源站。两个动作能立刻收敛:
- 在 CDN 上忽略无关的随机参数,也就是把缓存 Key 规范化,只保留真正影响内容的参数。这样带随机尾巴的请求会命中同一份缓存,不再回源。
- 开启回源合并(Request Collapsing),同一资源同一时刻只放一个回源请求出去,其余请求等这一个结果。突发穿透时,这一项对源站的保护往往比限流更立竿见影。
切片类直播(HLS/LL-HLS)还要检查缓存时间设置是否合理:索引文件(m3u8)按切片时长设短缓存,切片文件(ts/m4s)可以设较长缓存。设置要结合自己的切片时长来定,设得过短等于自己制造回源。
如果推流服务和拉流分发跑在同一台机器上,这次事故之后务必拆开——播放侧的压力不该有机会影响主播能不能推上来。
推流端口被占、或推流码被盗用
推流侧必须启用动态鉴权:用推流密钥 + 流名 + 过期时间戳生成签名(MD5 或 HMAC),服务端校验通过才允许建连。腾讯云直播等平台的防盗链就是这个形式,txTime 这类过期时间参数要设得足够短,够本场直播用即可。
过期时间的作用很实际:固定不变的推流地址一旦被抓包,攻击者可以重放,甚至抢占式推流占住你的流名和通道资源,表现出来就是主播“推上去又被顶下来”。事故当中如果怀疑推流码外泄,直接轮换密钥、重新下发带新签名的地址,比在网络层加规则更快。
对端口层面的空连接,四层清洗才是对症的手段——WAF 和七层 CDN 在这里帮不上忙。
第三步:源站收口,顺序别做反
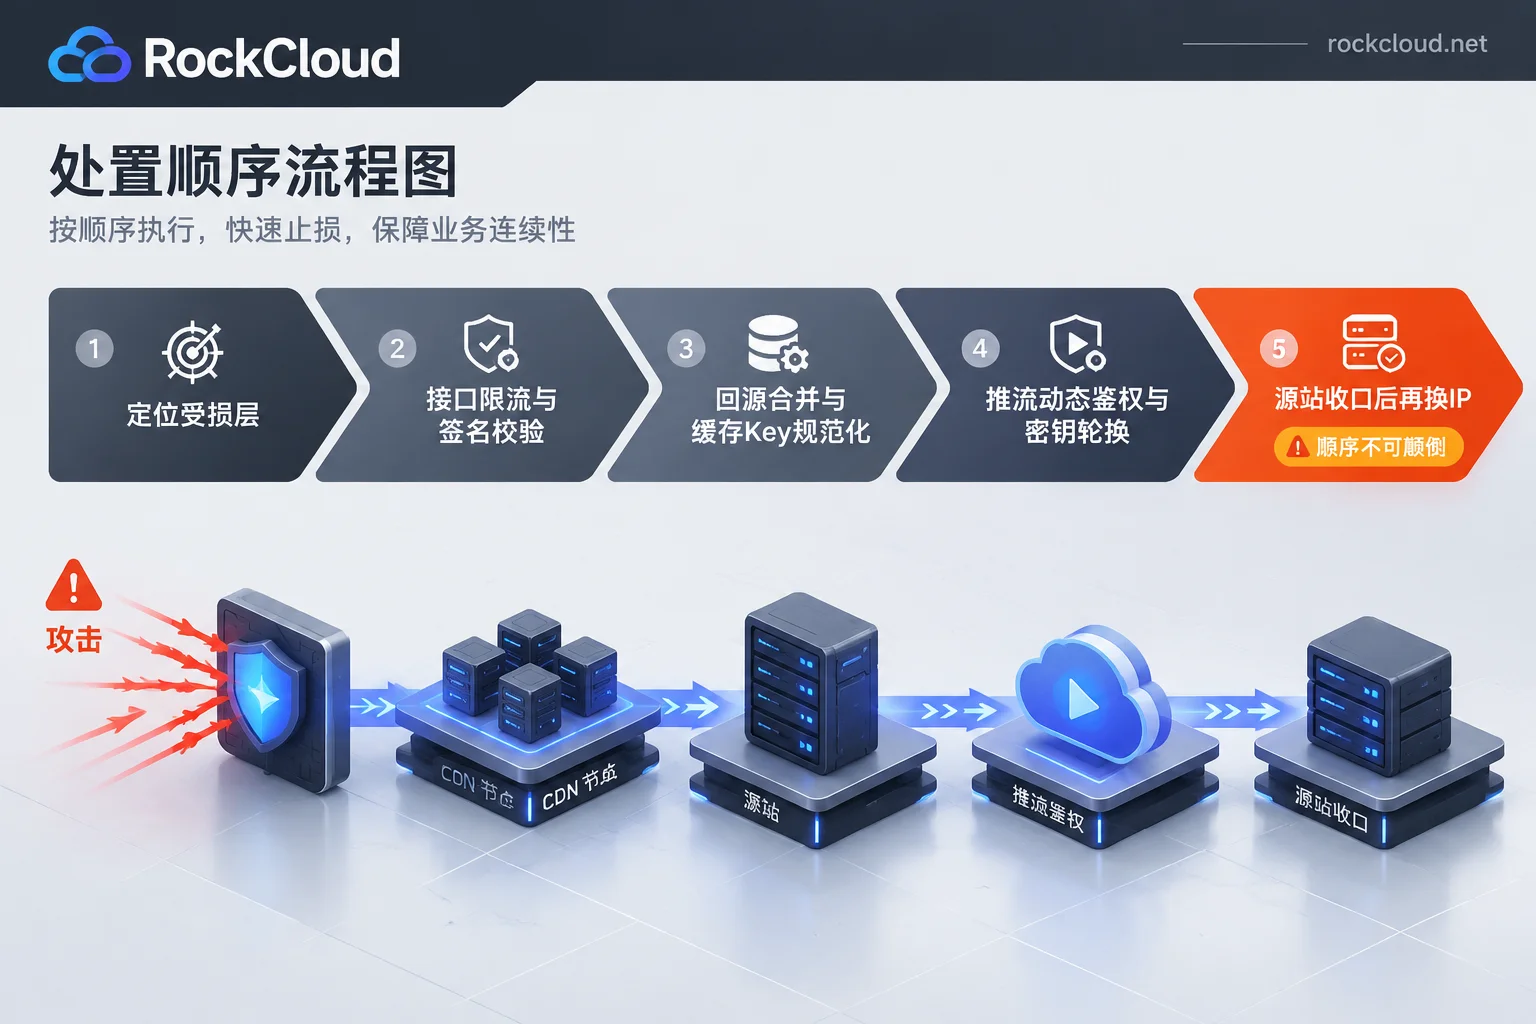
很多团队在这一步做反了:先换源站 IP,结果新 IP 很快又被打。正确顺序是先收口,再换 IP:
- 用安全组/防火墙把源站入站收成白名单,只允许 CDN 或边缘转发节点的回源地址进来,其余一律拒绝;管理端口(SSH、面板)单独限定来源。
- 排查还有哪些地方会泄露真实 IP:历史 DNS 记录、邮件服务、同 IP 上的其他站点、错误页回显、未走 CDN 的子域名。这几处不清干净,换 IP 是白换。完整的排查关口可以看源站隐藏怎么做。
- 确认源站只能从防护链路进来之后,再更换源站 IP,让旧 IP 上的攻击流量落空。
对 RTMP/SRT 这类四层长连接推流,收口意味着推流端也不再直连源站,而是连到支持 TCP/UDP 清洗、且能隐藏源站的四层网关或盾类节点上,由它把流量转发回来。如果你现在处在“推流端口正在被打、源站 IP 已经暴露”的状态,这类私有协议封装与 TCP/UDP 隐藏源站的接入方式是恢复推流通道最直接的一条路;事故进行中需要人配合切换的,直接走正在被攻击的应急入口比自己逐条试规则快。播放侧的 HTTP/HLS 分发仍然走 CDN,两条路径分别处理,不要混在一起。
有两件事会影响具体操作,动手前先确认
一是你用的推流协议。 RTMP over TCP、SRT over UDP、WebRTC/WHIP 在四层网关上的收敛配置并不一样:UDP 协议的清洗策略、会话保持和 MTU 相关的参数都要单独确认,不能照搬 TCP 的做法。接入前把协议和端口列清楚给到对接方,能少走一轮。关于 UDP 业务能不能靠 CDN 防,可以先看这篇的判据。
二是你现在的拓扑。 自建 SRS / ZLMediaKit 单节点源站,和已经挂在云厂商流媒体分发上的业务,应急切换步骤差别很大:前者改 DNS 和安全组就能收口,后者要先搞清楚哪一段是厂商托管的、你能改的是哪些开关。开播前把这张拓扑图画出来,事故时不用临时找人问。
事故之后补三样东西
- 推流与分发解耦:推流接入、转码、分发至少在部署上分开,避免一处被打全链路停摆。
- 鉴权常态化:动态签名不是攻击时才开,过期时间按场次设定,密钥定期轮换并记录下发日志。
- 可回溯的日志与告警:把控制层接口 QPS、回源请求量、推流端口连接数做成三条常看的曲线,并设阈值告警。事后要定性攻击类型、追溯来源,靠的也是这些日志,方法见DDoS 攻击日志分析与溯源排查。
最后提醒一句判断上的分寸:卡顿不等于一定被攻击。主播上行带宽不足、跨境线路抖动、一次正常的流量爆发,表现都可能像 CC。先看那四组数据里哪一组先异常,再决定动哪一层——这比任何单一防护开关都更能缩短恢复时间。


评论(0)